NVIDIAがBolt E4Bを発表:ローカルアシスタントやロボット向けの小型モデル、無駄話を減らし、より的確にツールを呼び出す
Gemma 4から追加学習を行い、簡潔な対話と連続的なツール呼び出しを両立。約6GBメモリという表記、ロボットのデモ、性能数値には、それぞれ見極めるべき前提条件がある。
NVIDIAはNemotron-3.5-Bolt-E4B 4GBを発表しました。これはローカルアシスタント、インタラクティブキャラクター、ロボット向けの小型モデルであり、自然な受け答えと、ツールを呼び出してタスクを完了させることに重点を置いています。モデルはGoogle Gemma-4-E4B-itをベースに構築され、強化学習による事後学習(事後トレーニング)を経ており、量子化後の目標ワークロードにおける動作VRAMは約4GBとなります。主な機能・特徴は以下の通りです。
- マルチターンのツール呼び出しとアクション決定:連続した対話の中でアプリケーションインターフェースを呼び出し、実行結果を読み取った上で次のアクションを決定することをサポート。
- 対話モードのワンタッチ切り替え:テンプレート内にスイッチを用意。有効化すると簡潔な指示が自動的に追加され、マークダウンなどの書式記号が抑制され、音声読み上げに適した口語調の短い文を出力。
- 調整可能な思考メカニズム:実行時に明示的な思考プロセスのオン・オフを切り替えることが可能で、思考トークンの予算上限を設定して応答遅延をコントロールする機能もサポート。
- 64Kコンテキストウィンドウ:システムプロンプト、複数ターンの対話履歴、ツール定義、環境状態、検索されたナレッジを収容。
- エッジのマルチデバイス動作:GeForce RTXグラフィックスカード、Jetson組み込みコンピューティングボード、RTX Spark、各種エッジデバイス向け。
4GBモデルと言うが、実際にはどれくらいのVRAMとメモリが必要なのか?
エッジ側での展開を議論する際、「8B」「4B」「4GB」「6GB」という表記は混同されがちです。Nemotron-3.5-Bolt-E4Bのリソース要件を理解するには、まずパラメータ規模、重みファイル、実行時メモリがそれぞれ何を指しているのかを区別する必要があります。
モデルの総パラメータ数は8Bで、有効パラメータ数(Effective Parameters)は4Bです。これはベースモデルであるGemma-4-E4Bの階層型埋め込み(PLE: Per-Layer Embeddings)設計を受け継いでいます。各層がトークンに応じてそれぞれの専用埋め込みテーブルを参照する仕組みで、テーブル自体のサイズは大きいものの、主に高速なテーブル引き(ルックアップ)に用いられ、通常の計算層のように毎回高密度な演算を行うわけではありません。そのため、総パラメータ数は8Bでありながら、有効な計算規模は約4Bと名付けられています。ただし参照テーブル自体を保存する必要があるため、これによって重みファイルの占有容量が半分になるわけではありません。(Bは十億を表します:8Bは80億パラメータ、4Bは40億パラメータです。パラメータはモデルの規模を示し、GBはストレージまたはメモリ容量を示します。)
量子化とは、重みの数値の保持精度を下げることで、モデルサイズと実行時のリソース要求を削減する手法です。採用する方式によってサイズと能力のトレードオフも異なります。実際のストレージや実行時において、重みファイル、VRAM占有量、システムメモリ(RAM)はそれぞれ異なります。
- 重みファイルのサイズ:BF16全精度の重みは約15GBです。公式が重要度マトリクス(imatrix)でキャリブレーションしたQ4_K_M 4ビット量子化GGUFファイルは約6.18GB、Unslothが公開したUD-Q4_K_XL量子化ファイルは約4.76GBです。ダウンロード時にはそれぞれの量子化仕様を確認してください。
- 実行時VRAM占有量:典型的なシングルセッションのワークロード(例:3,000トークン入力、50トークン出力)において、RTX 5070でのVRAM消費は約3.5GBです。32Kキャッシュを用いたマルチターンの長文セッションでは約4.3GBとなります。8GBのユニファイドメモリを搭載したJetson Orin Nano上では、推論ランタイム全体の占有量は約4.2GBから4.9GBとなります。これが名称に含まれる「4GB」の由来であり、目標とするワークロード下でのVRAM消費を約4GB前後に抑えることを意味しています。ここで6.18GBというのはディスク上の重み全体のサイズであり、3.5GBはGPUのVRAM占有量のみを計算したもので、実行にはシステムメモリとの協調も必要です。4GBは目標負荷下でのVRAM指標であり、マシン全体のメモリが4GBで済むという意味ではありません。
- システム実行メモリ(RAM):Unslothが提示している動作の目安は約6GB RAMです。実際の占有量は量子化バージョン、コンテキスト長、実行ソフトウェアによって変化します。「6GB」という表記を見た場合でも、OSや他のアプリケーションのために空き容量を確保しておく必要があります。
小型モデルのメモリ占有量が少なければ、音声認識、音声合成、認識モデル、各種アプリケーションが同一デバイス上で共存できる可能性が高まります。ただし、Jetsonの8GBはユニファイド(共有)メモリです。Boltによる占有に加えて、OSや他のプロセスのオーバーヘッドも計算に入れる必要があります。
なぜ無駄話を減らし、タスク実行に集中できるのか?
小型モデルがローカルアシスタントとして機能する際、冗長な回答は2つの問題を引き起こします。1つは長々とした内省(独白)に陥り、長文の分析を出力するばかりで一向にツールを呼び出さないこと。もう1つは、複雑なレイアウトや長文の説明を出力してしまい、音声読み上げ時の遅延が極端に長くなり、聞き取りづらく不自然になることです。
ベースモデルであるGemma-4-E4B-it自体は、すでに指示チューニング(IT)の基礎を備えています。NVIDIAは今回のNemotron-3.5-Bolt-E4Bの事後トレーニング段階において、追加の教師あり微調整(SFT)をスキップし、全行程で直接強化学習を採用しました。研究開発チームは多様な教師モデルのデータを用いたSFTを試行したものの、実験の結果、SFTはツール呼び出しの性能を引き上げる一方で、対話の質を低下させ、回答を冗長にさせることが判明しました。そのため最終バージョンでは、アクションが正しく行われたかどうか(ルールの直接検証によりツール呼び出しパラメータと実行結果の正確性を確認するなど)や、回答が自然かどうかを先に検証し、それらのフィードバックをもとに学習を継続する手法を選択。検証可能な結果に基づく報酬(RLVR)と、好みのフィードバックに基づく報酬(RLHF)を組み合わせています。(トレーニングはNeMo-RLおよびNeMo-Gymフレームワーク下で実施されました。)
対話における小型モデルの俊敏性を高めるため、トレーニングでは3つのメカニズムが導入されました。
- 非思考サンプルと思考サンプルの2:1の比率配分:トレーニングセット内の各サンプルについて、思考有効(
enable_thinking=true)と思考無効(enable_thinking=false)の両方のモードで生成と報酬評価を個別に実施。トレーニングバッチ内で非思考サンプル2に対し思考サンプル1の比率を維持することで、明示的な中間推論チェーンを経由しない場合でも、モデルが指示を正確に理解して正しいアクションを出力できるようにしました。 - 長さに対するペナルティの動的調整:強化学習が進むにつれ、モデルはエラーを回避するために推論プロセスを長引かせる傾向があります。チームは生成報酬モデル(GenRM)環境において過度に長い思考や回答を減点し、減点の強度を周期的に調整(ペナルティの緩和と厳格化を交互に行う)することで、正解率と簡潔さを同時に向上させました。出力長の比較に関して公式が公表した結果によると、BF16における21項目のベンチマーク総合評価(大半のタスクで思考有効、EQ-Bench、RoleBench、RULERでは無効)において、Boltの平均スコアは63.9点、平均出力は672トークンでした。これに対しベースのGemma-4-E4B-itは平均58.1点、出力782トークン、同規模のQwen3.5-4Bは平均57.8点、出力は3,604トークンに達しました。Boltの平均出力はここでのQwenより約81%少なく、Gemmaより約14%少なくなっています。したがって「最大で約80%少ない」というのは比較対象に依存する表現であり、長さペナルティはトレーニングにおける選択肢の1つであって、この比較はモデル全体の結果を測定したものです。
- 「まず発話、次にアクション」のテンプレート配置:チャットテンプレートにおいて、アシスタントの返答に自然言語とツール呼び出しの両方が含まれる場合、テンプレートは説明的なテキストをツール呼び出しの前に配置します。これによりエージェントは、時間のかかるツールを実行する前に、まずユーザーに対して口頭で説明(例:「今日の天気を照会しています…」など)を行ってから呼び出しコマンドを発行することができ、対話における確認と実際のアクションがスムーズに連携します。
公式はゲーム内の鍛冶屋商人NPCのテストも実施しました。プレイヤーが金の斧が欲しいと伝えると、NPCはダイヤモンド2個の支払いを要求します。プレイヤーがまず1個渡すと、NPCは明確にもう1個を補うよう要求し、ダイヤモンドが2個揃った段階で自発的にツールを呼び出して合成レシピを照会し、素材を取り出し、金の斧を製作してプレイヤーに渡します。この実行チェーンにおいて、モデルはツール呼び出し要求の出力を担当し、外部のホストアプリケーションがローカル環境で対応する実際のAPIを実行し、実行結果と新しい状態をモデルに送り返します。モデルは最新の根拠に基づいて次のアクションと対話を進め、完全なリクエストと実行のループを維持します。
プレイヤーがまずダイヤモンドを1個渡すと、鍛冶屋は2個目を揃えるよう要求。揃った後で初めて素材を取り出し、金の斧を製作してプレイヤーに渡す。出典:NVIDIA公式デモ、約33秒、音声トラックなし。
ローカル環境でどれほど速く動くのか?初回トークン遅延と生成速度のパフォーマンス
ローカルアシスタントの応答速度を評価する際は、初回トークン遅延(TTFT: Time to First Token)と生成スループット(TPS: Tokens Per Second)を分けて分析する必要があります。前者は主に入力を読み取る「プリフィル」段階の影響を受け、後者は内容を段階的に生成する「デコード」段階を測定します。
初回トークン遅延とは、ユーザーのリクエストがモデルに入力されてから最初のトークンが出力されるまでの時間を指します。主にプリフィル段階の計算に左右されますが、音声対話における「ユーザーが話し終えてからスピーカーから音が出るまで」のエンドツーエンドの全体遅延と同一ではありません(エンドツーエンドには音声認識やオーディオ伝送などの工程も含まれます)。生成スループットは、デコード段階に入った後、モデルが1秒間に何トークンを生成できるかを表します。ハードウェアテストにおいて、32Kキャッシュはすでにキャッシュされたコンテキスト、2Kは今ターンの新規入力、256は今ターンの出力を指します。2組の負荷テストでは複数の条件が同時に異なるため、2つの結果の差をすべてキャッシュ長の要因として帰着させることはできません。
4本の横線は同一の時間軸を使用:短いほど最初のトークンが早く到達。数値はすべてNVIDIAによる測定値。
現在:キャッシュなし、3K入力、50出力。2組の負荷条件ではキャッシュ、新規入力、出力の長さが同時に変更されています。
Q4_K_M · llama.cpp CUDA · シングルセッション。TTFTはモデルへのリクエストから計測され、音声認識や音声合成は含まれません。占有量は公式シートのVRAM指標です。Jetsonは共有メモリを使用するため、容量からモデル占有量を引いた値が他アプリの実際の利用可能メモリを表すわけではありません。
データは公式AIPerfを用い、llama.cpp(CUDA、Q4_K_M)下で測定。長文コンテキストは32Kキャッシュに2K入力、256出力を組み合わせた構成。
公式が公表したQ4_K_M量子化下でのベンチマークデータを例に挙げます。
- デスクトップ向けディスクリートGPU RTX 5070(12GB) では、3,000トークンの標準入力に対し、TTFTは548ミリ秒、TPSは133.4 tok/sに達します。
- 一方、計算能力が制限される組み込みエッジデバイス Jetson Orin Nano(8GB) では、同一の3,000トークン入力を処理する場合、初回トークン遅延は 5,785ミリ秒(約5.8秒) に上昇し、デコードレートは15.5 tok/sとなります。
この同一負荷での比較が示すように、計算能力が低いエッジデバイスでは、長いシステムプロンプトや過去の対話コンテキストが存在する場合、プリフィル段階に起因する初回トークン遅延によってユーザーの待ち時間が大幅に延びるため、開発者は入力長を厳格にコントロールする必要があります。
生成フェーズにおいてデコードスループットを向上させるため、本モデルにはDFlashアーキテクチャに基づく並列投機的サンプリングドラフトモデル(DFlash Parallel Drafter)が併せてリリースされています。投機的サンプリングとは、小さなドラフトモデルが次のトークン列を先回りして素早く予測し、メインモデルが一括して検証して通過した部分を採用することで、一度に複数のトークンを確定させ、メインモデルが1つずつ逐次生成する回数を減らす手法です。このドラフトモデルは5層のTransformerで構成され、1回の順伝播で同時に7個の候補トークンを予測し、メインモデルが並列検証を行います。この検証プロセスではメインモデル本来の確率分布が厳密に保持されます。
高速化の効果について、正確に対応するテストベースラインは以下の通りです。
- RTX PRO 6000上でBF16 NIMサービスを実行し、思考有効、並列数1とした場合、DFlashを組み合わせた単一ユーザーのデコードレートは投機的サンプリングなしのベースラインの2.74倍に向上(124.7 tok/sから341.2 tok/sへ向上)。
- RTX 5070上でバッチサイズ1としてSPEED-Bench codingサブセットをテストした際、両ターゲットモデルともQ4_K_M量子化を採用し、BoltにBF16 DFlashドラフトモデルを組み合わせた場合の生成スループットは272.6 tok/sに達し、Gemma-4-E4B-it公式標準のMTP方式(225.9 tok/s)と比較して21%向上(1.21倍に到達)しました。これは前述の133.4 tok/sとはテスト条件が異なるものであり、両者を混同してはなりません。
DFlashが加速するのはその後の生成プロセスです。上述のNIMテスト環境において、初回トークン遅延の変化は100ミリ秒未満にとどまっており、入力が非常に長い場合の入力読み取りに伴う待ち時間は、別途解決する必要があります。
画像や音声を理解できるのか?マルチモーダルと多言語能力の実測
BoltはGemma 4の画像理解や音声認識能力を受け継いでいますが、具体的にどのような入力形式を利用できるかはデプロイ方式に依存します。公式のベースGGUFモデルカード上の入出力表記は Text / text となっていますが、公式のNIM BF16マイクロサービスではテキスト、画像、音声の入力をネイティブでサポートしています。またUnslothのリポジトリでは、マルチモーダルツールで読み込むための mmproj 追加ファイルが提供されています。画像を認識させるには適合するモデルファイルと実行ツールが必要であり、テキスト用のGGUFを読み込んだだけでは視覚入力が接続されたことにはなりません。
受け継がれた能力にも、方向性の異なる変化が生じています。
- 視覚理解の低下:Gemma-4-E4Bのベースモデル自体はマルチモーダル能力を備えていますが、テキストのみによる強化学習の事後トレーニング過程で、ビジョンエンコーダーと言語モデルの間でアライメントのドリフトが発生しました。ベンチマーク評価によると、Gemma-4-E4B-itと比較して視覚指標の低下が見られます。思考有効モードにおいて、ドキュメント認識ベンチマークOmniDocBench 1.5の指標(数値が低いほど優秀)は0.21から0.42に悪化。学際的な視覚理解MMMU-Pro Visionは47.63から42.02に低下し、MathVisionは48.29から46.25へと低下しました。チームはビジョンエンコーダー単体のトレーニングも試みましたが、顕著な改善は見られませんでした。
- 音声理解能力の向上:思考有効モードにおいて、Bolt-E4Bの単一ターン音声ベンチマークVoiceBenchでのスコアは80.30(ベースモデルの78.20を上回る)を記録し、マルチターン音声評価Audio MultiChallengeでは25.22(ベースモデルの19.03を上回る)に達しました。両モデルとも最長30秒の音声入力をサポートしていますが、AudioMCに含まれる対話の50%以上で30秒を超えるターンが存在するため、評価スコアは各ターン30秒という音声入力上限の制限を受けており、切り詰められていない完全な対話すべてをカバーしているわけではありません。またこれらのスコアは音声入力の聞き取りを評価するものであり、回答を音声として読み上げるには別途音声合成が必要です。
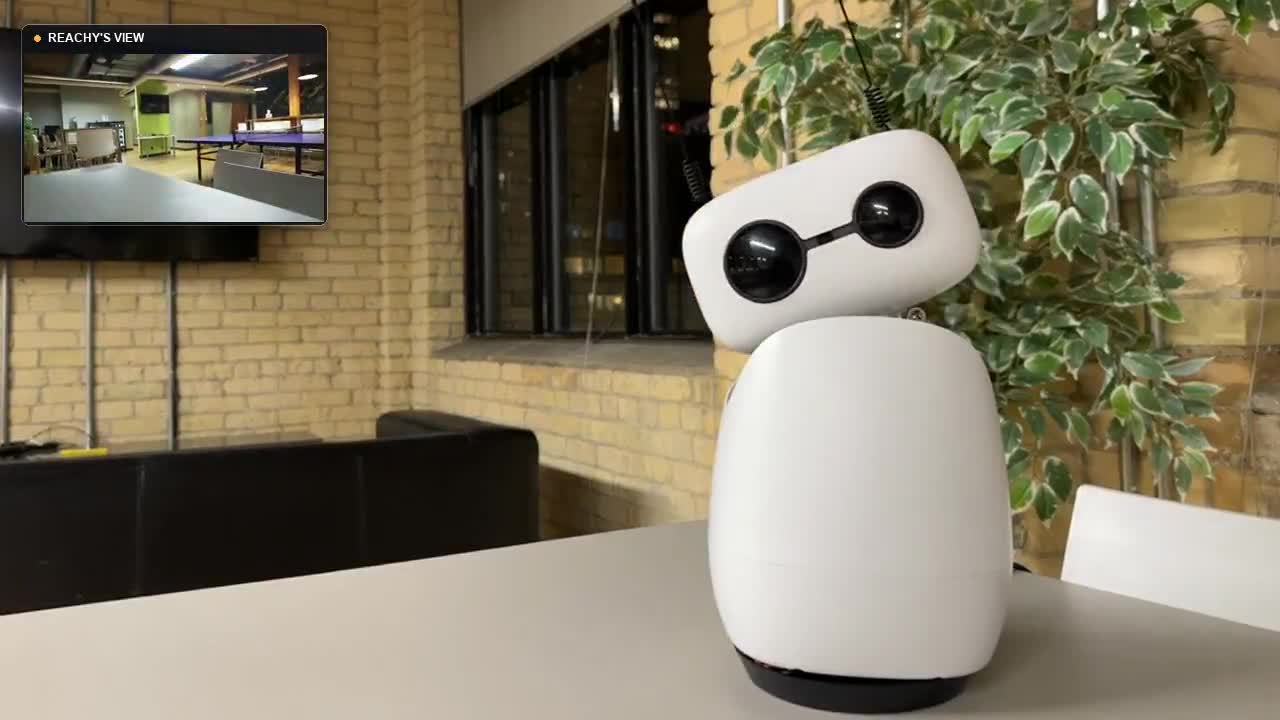
- ロボットデモにおける認識と動作の役割分担:公式から公開されたReachy Miniデスクトップロボットのデモにおいて、リアルタイムの環境視覚理解はNVIDIA Cosmos 3 Edgeが担当しています。Bolt-E4BはCosmosから送られてくる認識結果を受け取り、対話ロジックの構成と、ロボットの既存アニメーションライブラリ内の動作スクリプトを呼び出して身体の反応を駆動する役割を担います。両モデルはJetson Orin Nano 8GB上でローカルに協調動作しています。
- 多言語性能のトレードオフ:今回の事後トレーニングには英語データが使用されましたが、WMT24++評価によると機械翻訳の品質はおおむね維持されています。一方、多言語の知識・推論(MMLU-ProX)では、わずかながら一貫したスコア低下が見られました。思考有効モードにおいて、中国語のMMLU-ProXスコアは65.17となり、ベースモデルのGemma-4-E4B-it(66.78)と比べて1.61ポイント低下しました(非思考モードでは63.32で、1.12ポイント低下)。
Cosmos 3 Edgeが環境認識を担当し、Boltが認識結果を受け取って対話を構成し、既存のアニメーションを呼び出す。両モデルともJetson Orin Nano 8GB上で動作。出典:NVIDIA、約25秒、音声トラックなし。
ベンチマークテストの結果:何が得意で、何に適していないのか?
NVIDIAが報告した「Nano 4Bと比較して平均約40%向上」という数字は、21項目のベンチマークを対象としています。ポスト(ツイート)画像にある70.2というスコアは、そのうち6項目のタスクにおけるQ4_K_Mの平均成績であり、画像内の初回トークン速度はRTX 5090上で約3,000トークン入力・約50トークン出力の条件で測定されたものです。70.2という数値をスマートフォン上での速度や汎用能力の総合スコアとみなすことはできません。
スコアはNVIDIAが統一されたNeMo-Gymフレームワーク下で測定したものであり、同一条件下での比較観察に適しています。なお、Brevity BenchmarkとWhen2Call-MTは現時点では一般公開されていません。
下図に示す6項目のテストにおける思考モードは完全に一様ではありません。RULERはBF16とQ4_K_Mの両方の精度で明示的な思考が無効化されており、残りの5項目では思考が有効化されています。思考を無効化するとダイレクトに応答できるようになりますが、特定のタスクにおける正解率とのトレードオフが伴います。例えばBF16において思考を無効化すると、When2Call-MTのスコアは63.36から51.25へ、Tau2-Benchは55.10から34.34へと低下します。全21項目のベンチマークにおいて、Boltの非思考モードは同クラスの競合相手の中で14項目で最高点または同率最高点を獲得しています。思考を無効化するかどうかは、タスクに求められる正解率を踏まえて判断する必要があります。
評価条件:RULERは思考無効、残りの5項目は思考有効。BF16とQ4_K_Mはいずれも各設定を踏襲。上のスイッチは重みの精度のみを切り替え、思考モードは切り替えません。
データはテクニカルレポートのTable 3(BF16)およびTable 5(Q4_K_M)を出典とし、NeMo-Gymの同一評価パイプラインで測定。現在比較されている6指標のうち、RULERは両精度とも思考モードが無効、残りの5指標はすべて思考モードが有効。
1. 際立つ強み:ルール遵守とツールの判断
- システム指示の競合遵守(IHEval BF16 84.79 / Q4_K_M 82.40):システムの事前設定とユーザー指示が競合する場合や悪意ある誘導テストにおいて、Bolt-E4Bのシステムルール遵守性能は、ベースのGemma-4-E4B-it(BF16 67.04 / Q4 66.61)やQwen3.5-4B(BF16 60.57 / Q4 62.87)を明確に上回っています。これは事前設定ルールをより維持しやすいことを示していますが、遵守に失敗するケースが完全になくなるわけではありません。
- マルチターン制約とペルソナ(役柄)の維持:連続したマルチターン対話の中でルールを一貫して遵守し、キャラクター設定を維持することは、ローカルな対話型エージェントにとって特に重要です。思考有効モードにおいて、マルチターンコンテキスト指示と制約の一貫性をテストするMultiChallenge(BF16)で、Bolt-E4Bは53.10点を記録(ベースのGemma-4-E4B-itは42.08点)。ペルソナ読解とペルソナ適合のベンチマークであるRoleMRC(BF16)では、Bolt-E4Bは80.63点に達しました(ベースモデルは74.62点)。これら2つの結果は、ベースモデルと比較して複数ターンの制約を記憶し、与えられたアイデンティティに沿って応答することに優れていることを示しています。これは感情を汲み取れるかどうかとは別の能力です。
- 呼び出しタイミングの判断(When2Call-MT BF16 63.36 / Q4_K_M 60.50):Qwen3.5-4B(BF16 37.85 / Q4 42.88)と比較して、Bolt-E4Bは直接回答すべきか、外部ツールをトリガーすべきか、ユーザーに質問して明確化を求めるべきかをより安定して判断でき、ベースのGemma-4-E4B-it(BF16 62.90 / Q4 61.12)と同等のパフォーマンスを示します。
- 回答の簡潔さ(Brevity Benchmark BF16 82.52 / Q4_K_M 82.84):回答の中核となる情報を保持した上で、ベースのGemma-4-E4B-it(BF16 79.99 / Q4 78.49)やQwen3.5-4B(BF16 75.35 / Q4 75.17)よりも簡潔な表現を行います。
- ツールの誤情報耐性(RelyToolBench BF16 63.16 / Q4_K_M 69.29):呼び出した外部APIが虚偽または誤ったフィールドを返してきた際、モデルが妨害に耐えて実行を修正する能力は、Qwen3.5-4B(BF16 43.35 / Q4 38.34)を大きく上回っています。
- 検索資料の根拠と事実の選択:検索された資料から根拠ある事実を抽出する能力は、ツール異常時の耐干渉性とは性質が異なります。例えばローカルアシスタントがデバイスのマニュアルやローカルナレッジベースを読み取った後、提供された内容に基づいて正確に回答し、資料を離れた捏造を防ぐ必要があります。思考有効モードにおいて、検索資料に基づき事実を生成する能力を測るGaRAGe(BF16)では、Bolt-E4Bは42.61点を記録し、ベースのGemma-4-E4B-itの34.73点を上回りました。一方、根拠のない記述を識別するRAGTruth(BF16)では、Bolt-E4B(77.59)のベースモデル(76.97)に対する改善幅はわずかであり、回答に根拠を欠く記述が含まれる可能性は依然として残ります。
2. 明確な弱点:複雑なマルチステップタスクと長文検索
- 複雑なマルチステップのカスタマーサポートタスク(Tau2-Bench BF16 55.10 / Q4_K_M 52.32):ユーザー状態の遷移や予約の変更・キャンセルなどを含む複雑なマルチステップのサポートタスクにおいて、Bolt-E4BはベースのGemma-4-E4B-it(BF16 38.50 / Q4 38.72)を上回っているものの、Qwen3.5-4B(BF16 75.06 / Q4 61.74)には大きく水をあけられており、複数ステップの計画タスクでは苦戦が見られます。
- 超長文テキスト検索(RULER 64K BF16 86.99 / Q4_K_M 85.76):64Kのフルコンテキストにおける正確な情報検索において、スコアはベースのGemma-4-E4B-it(BF16 86.55 / Q4 86.14)に近いものの、Qwen3.5-4B(BF16 95.15 / Q4 95.37)を下回り、前世代のNano 4B(BF16 91.51 / Q4 91.31)にも及びません。長大なドキュメントの高密度な検索は得意分野ではありません。
- 感情理解と共感(EQ-Bench v3 BF16 39.40 / Q4_K_M 38.15):この評価は思考無効モードで実施されており、スコアはベースのGemma-4-E4B-it(BF16 41.17 / Q4 39.77)をわずかに下回っていますが、Qwen3.5-4B(BF16 32.92 / Q4 32.07)よりは高いスコアとなっています。
実際に試してモデルを呼び出すには?
モデルをダウンロードまたは設定する際は、E4Bの仕様であることを確認し、同一シリーズ内で容量がはるかに大きい74B仕様(74B-A9Bなどは重みが20GBを超え、全く異なるハードウェア構成を必要とします)を誤ってダウンロードしないよう注意してください。
1. GUI環境での試用(Unsloth Desktop)
Mac、Windows、またはLinux上で手軽に対話を体験したいユーザーに適しています。
- Unsloth Desktopアプリケーションを開き、Model Hubに入ります。
Nemotron 3.5 Boltを検索し、リストから E4B 仕様(例:NVIDIA-Nemotron-3.5-Bolt-E4B-UD-Q4_K_XL.gguf)を明示的に選択します。- 初回の体験時は、短いコンテキストの出発点としてコンテキスト長を4,096または8,192トークンに設定し、実際のハードウェアVRAMの挙動を見ながら段階的に調整することをお勧めします。すべてのデバイスがそのまま長文コンテキストの実行要件を満たせるわけではありません。
2. 開発者向けのデプロイ参考
NVIDIA GPUを搭載したLinux開発者は、公式のHugging Faceモデルカード(nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB)およびNIMガイドを参照してコンテナデプロイの手順を確認できます。サービス起動時は、実際のVRAM容量に応じてコンテキストウィンドウのサイズを適切に設定し、いきなり64Kコンテキストを指定してメモリ不足(OOM)を起こさないよう注意する必要があります。
3. コア呼び出しパラメータとモード制御
APIクライアント経由で呼び出す際は、公式推奨の設定と固有のパラメータに留意してください。
- サンプリングパラメータ:公式では、思考有効モード・思考無効モードのいずれにおいても
temperature=1.0およびtop_p=0.95の維持が推奨されています。 - 対話モード(conversational_mode):呼び出し時に
chat_template_kwargs={"conversational_mode": True}を渡すと、テンプレートによってシステムプロンプト内に簡潔で複雑な書式を抑えた口語的な指示が追加されます(すべての書式が強制的に削除されるわけではありません)。このスイッチは思考モードとは独立しており、自由に組み合わせて設定できます。 - 思考モードの制御(enable_thinking):
chat_template_kwargs={"enable_thinking": False}を指定することで明示的な思考プロセスを無効化し、直接回答を出力させることができます。ただし、これは思考チェーンを出力しないことを意味するだけであり、内部で推論が完全に行われないことを意味するわけではありません。思考トークンの予算上限を設定したい場合、--reasoning-budgetはllama.cppのllama-server起動オプションであり、NIMではリクエスト単位のthinking_token_budgetパラメータで制御します。ハードリミットを設けると推論プロセスが途中で打ち切られるため、具体的なタスクに合わせた検証が必要となります。また、音声認識やツール実行といった他の工程に起因する遅延は別途対処が必要です。 - オープンソースライセンスに関する説明:モデルの重みはOpenMDW-1.1ライセンスに従っており、公式モデルカードには商用または非商用シナリオで使用可能と明記されています。ベースのGemma 4はApache 2.0ライセンスを採用していますが、今回の事後トレーニング済み重みはOpenMDW-1.1の条項を遵守する必要があり、利用時は記載されたライセンスに従って取り扱う必要があります。
Nemotron-3.5-Bolt-E4B 4GBは、エッジ側の限られたリソースにおけるローカルアシスタントや制御された対話シナリオに焦点を当てています。回答の簡潔化、マルチターンのツール操作、システム指示の階層遵守において優れた性能を発揮し、迅速なレスポンスが求められるデスクトップコンパニオン、車載音声システム、ロボットの動作スケジューリングなどのタスクに適しています。一方で、超長文の検索や複雑なマルチステップの業務計画には依然として明確な弱点が存在します。実環境への導入にあたっては、自社のデバイスが許容できる遅延水準と具体的なタスク要件に合わせて、十分な検証と選択を行う必要があります。