LLM 能像爱因斯坦一样提出新理论吗?《LLMs can’t jump》的科学创造之争
从电梯思想实验出发,理解推导已有前提、提出新解释和检验物理世界之间的差别。

Google DeepMind 研究员 Tom Zahavy 在个人立场论文《LLMs can’t jump》中追问:如果只给 AI 爱因斯坦当时掌握的知识,它能否提出广义相对论所需的新物理原理?
这个问题比“AI 能不能做科学发现”更具体。Zahavy 参与过 AlphaProof,也认可基于大语言模型的系统已经在产生真实发现。论文主张,当前 LLM 缺少从物理经验形成新理论前提的机制。这就留下一个具体问题:在没有大量反常数据指路时,系统怎样迈出这一步?
模型可以依据一套理论算出预测,也可以从数据里寻找规律。爱因斯坦提出等效原理却还做了一件事:设想观察者自由下落时会经历什么,再把这个思想实验提升为关于物理世界的原则。论文把这一步称为“跳跃”。
同一个下落现象,可以问三种不同的问题
演绎追问会发生什么,归纳寻找共同规律,溯因提出可能的解释。新解释还要接受检验。
演绎:从规则算结果
已知引力规律 + 初始条件 → 下落预测
假定某套物理理论成立,算出物体怎样运动。推导正确保证结论符合前提;前提能否描述世界,还要靠观测。
归纳:从案例找规则
多次下落观测 → 总结共同规律
比较不同物体的运动记录,发现忽略空气阻力后,它们在同一位置以相同加速度下落。总结可推广到哪里,仍需检查。
溯因:为现象提解释
下落的一致性与局部失重 → 提出等效假说
进一步设想:重力和加速的局部对应,是否体现了一条更普遍的物理原理?这是待推导、待检验的解释候选。
复述:讲出已经知道的答案
读过电梯思想实验 → 回答相关提问
能讲出相对论,不足以证明模型在没有见过答案的条件下也能独立提出它;同样,单凭这次回答也不能断定模型只在背诵。
科学发现的三种推理与一个常见误区
从已有规则推结果、从案例找规则、为现象提解释,是三种不同的任务。皮尔士对推理的区分,可以用物体下落这个例子理解:
- 演绎:规则与初始条件 → 预测。 给定引力规律和物体初始状态,推算它怎样下落。如果前提为真、推导有效,结论才可靠。形式化证明工具可以核对推导是否符合规则,物理前提能否描述现实仍需观测检验。
- 归纳:观测案例 → 一般规律。 比较不同物体的下落记录,总结忽略空气阻力后,它们在同一位置以相同加速度下落。案例可以很多,也可以较少;总结出的规则能推广多远,需要继续检验。
- 溯因:背景知识与现象 → 候选解释。 看到物体一致下落、自由落体者局部失重,进一步设想这些现象是否体现同一个物理原则。提出解释不保证解释正确,它只是给后续推导和检验提供了新起点。
如果询问模型“人在下落的电梯里会有什么感觉”,它可能给出准确答案。但训练资料可能早已包含电梯思想实验,所以这次回答不足以证明它能独立发明等效原理;同样,也不能只凭答案就断定它内部没有推理。要检验独立发现,必须控制系统能接触的知识和现成答案。
“数据压缩即创造”的理论困境
一种由计算机科学家施密德胡伯等人倡导的观点,把科学发现看作压缩:用更简洁的规则解释更多观测。例如,与其逐条记录运动轨迹,不如找到一组能生成这些轨迹的规律。
Zahavy 对这种解释提出的挑战是:广义相对论诞生时,没有一大批清楚要求“改用弯曲时空”的反常数据。牛顿引力能解释大量观测,但水星轨道仍有异常。有人尝试用太阳附近尚未发现的“祝融星”解释它;同一异常,并不唯一指向一种新理论。
当时也存在概念上的张力:牛顿引力的远距作用,怎样与相对论和场论的图像相容?Zahavy 承认,AI 可能识别这类不一致。因此,数据稀缺不能简写成没有问题、没有反馈或算法完全没有方向。
论文真正质疑的是:如果目标主要是改善现有数据的预测误差,什么会促使系统放下表现很好的旧框架,尝试一套全新的时空概念?这是对研究目标的质疑,论文并没有实际训练一个历史模型、测得其损失接近零,再观察它无法突破。
最终理论更简洁,也不等于寻找它的每一步都更简单。 新数学工具、错误方程和被放弃的假设,可能先扩大候选空间、增加复杂度。只奖励眼前拟合或压缩改善,是否足以支持这种探索,正是作者提出的问题。
检验也有新旧之分:水星轨道是既有观测,后来成为重要检验;日食星光偏折则在理论提出后接受新的观测检验。科学家可以先提出解释,再寻找能区分新旧理论的证据。
扎哈维的论证:身体模拟、具身跳跃与认知盲区
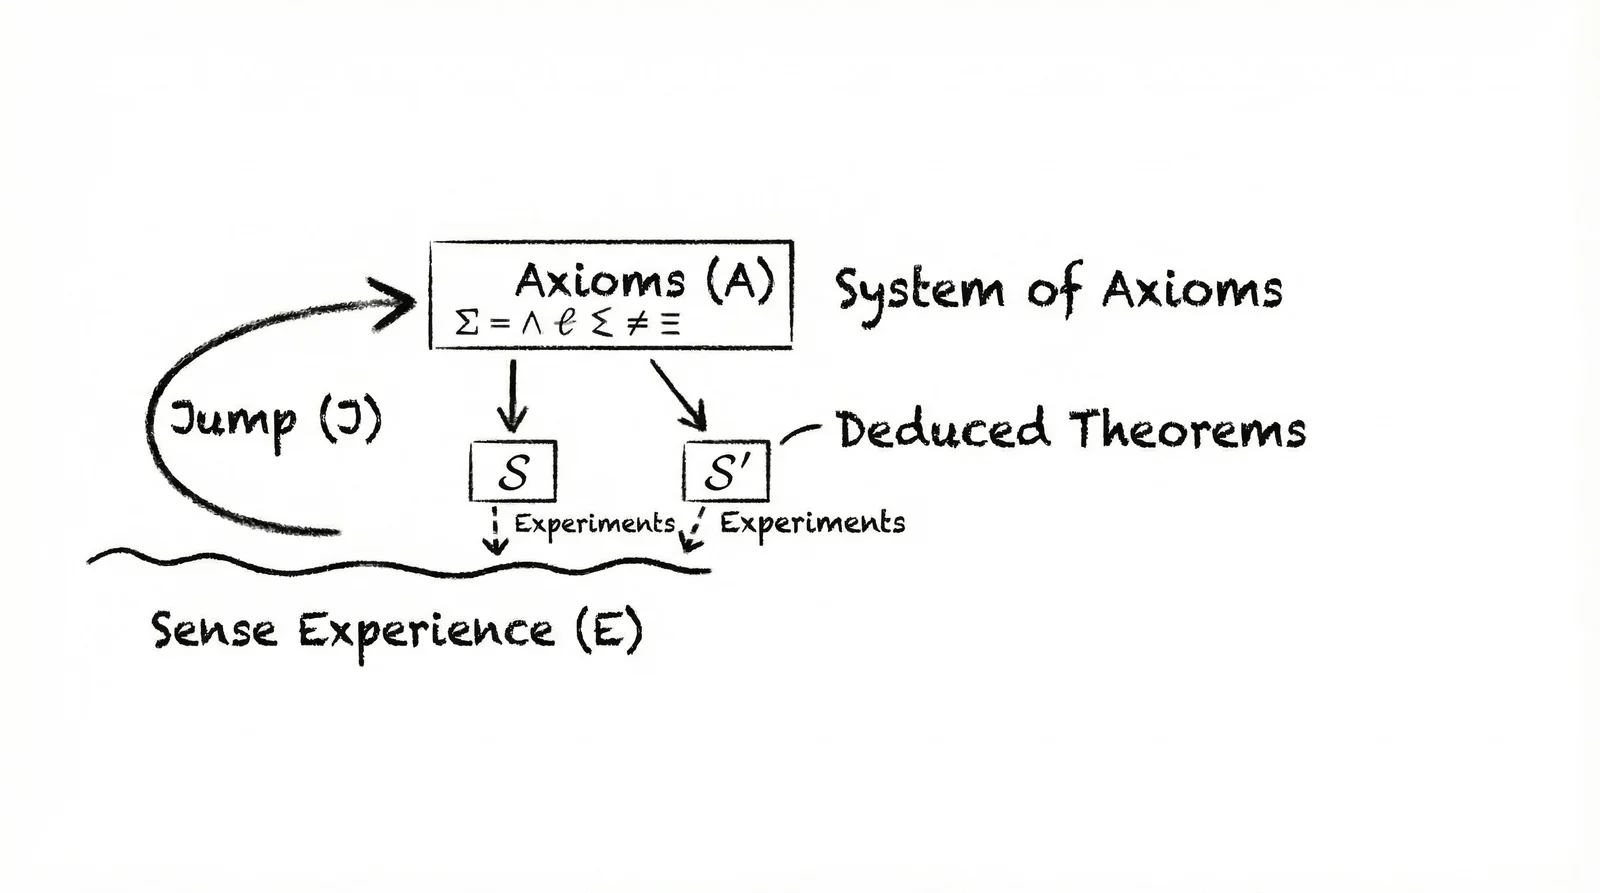
爱因斯坦在写给莫里斯·索洛文的信中,用一个循环描述科学创造:经验 → 提出理论前提 → 推导可测后果 → 实验检验 → 新经验。论文关心的是从经验到新前提的那一步。论文中的循环图是 AI 重绘的示意,电梯图也由 AI 生成;它们解释概念,不能充当模型能力实验。
一次发现,怎样回到现实接受检验?
↶ 检验结果成为新经验,继续追问
这里的理论前提,是后续推导暂时接受的基本假设或物理要求。论文整理了爱因斯坦探索中的七项要求,包括局部等效、能量与动量作为引力来源,以及弱引力、慢速条件下回到牛顿结果等。Zahavy 判断,若给定这些前提,现代 AI 有可能承担方程搜索、推导和排错;这篇论文没有实际做限制历史知识的模型重发现测试。
提出前提又是怎样发生的?电梯思想实验提供了两组对照。在足够小的区域和短时间内,忽略潮汐效应:
- 地球附近的自由落体舱,与深空惯性漂浮舱,都让人失重。 在前一间舱里,人、舱体和松手的小球一起下落,小球相对人近似漂浮。这里的重力并未消失,只是舱内局部运动近似呈现无引力环境。
- 地面静止舱,与深空向上加速舱,都能让人感到重量。 在后一间舱里,地板向上追赶松手的小球;取约 9.8 m/s² 的加速度,可以近似对应地面的下落情景。
爱因斯坦把这种对应推广到比小球下落更广的范围:在足够小的自由落体实验室中,忽略潮汐效应,局部的非引力物理实验应当遵循与无引力惯性实验室相同的规律。 这项主张不再只解释“人为什么失重”,还要求光信号、钟等其他物理过程也能在局部等效的框架下得到一致描述。Zahavy 将这种借助可操纵的心理场景产生解释的过程称为“操纵式溯因”:改变情境,比较后果,再提出更一般的假说。
把小球换成一束光,就能看到新前提怎样带出新问题。设想深空火箭最初静止,随后向上加速;从左壁水平发出的光,在外部惯性观察者看来沿直线传播。光飞行期间,火箭舱体已经向上移动,因此舱内观察者会看到光路向地板一侧偏。加速与重力的局部对应,使人进一步追问:引力环境中的光传播也应受到怎样的影响?AEI 的光线偏折讲解说明了这条推理的作用与限度:局部对应能提供预测线索,太阳旁光线的完整偏折量,还需要整体时空几何。
钟也给出可以检验的后果。在地球附近的稳定引力环境中,把相同的钟放在不同高度,让低处的钟每次“滴答”都向高处发送一个光脉冲。高处观察者用自己的钟比较,会发现收到的脉冲间隔比本地同样的“滴答”更长,据此判断低处的钟走得更慢。从低处向高处传播的连续光,接收频率也会降低,这称为引力红移。每个观察者在自己身边都觉得钟正常走;差别通过不同位置之间的比较显现。这类后果把一种新原则变成了能推导、能测量的主张。
同一束光:直行与向下偏,怎样同时成立?
火箭最初相对外部观察者静止,随后向上加速。一束光从左壁水平发出。拖动飞行进程,同时比较舱外与舱内视角。
外部惯性观察者
虚线保留舱体初始位置,便于看出它的移动。
火箭舱内观察者
舱体作为参照保持不动;虚线是初始的水平方向。
同一时刻:舱外看光直行、火箭上移;舱内看光逐渐偏向地板。
作者认为,纯粹处理物理语言可能缺少形成这种直觉的经验基础。但这仍是机制论证,不能从一段逼真的下落视频,就断定生成模型内部一定有或一定没有可靠的物理表征。论文也承认,ARC-AGI 这类少样例网格任务已在测试寻找隐藏规则的解释性推断;它追问的是,这是否覆盖了主动构造物理情境、获得经验并形成新原则的过程。
因此,论文建议探索可主动干预、物理规律保持一致的世界模型。系统需要能改变条件,例如设想剪断电梯缆绳,再比较后果;随后把不同情景中的关系抽象成可检验命题,交给数学推导和实验核对。物理先验可以帮助缩小候选空间,但模拟器也可能学错规律,能操作环境并不自动等于能发明理论。Genie 一类可控环境启发了这条路线,其存在本身并未证明这个难题已经解决。
这里还有“研究什么”的主动性:研究者会自己制造问题的变化,再决定哪种后果值得追查。论文以测试时强化学习为相邻能力的例子,承认系统可以生成新的棋局或数学问题并学习求解;它继续追问的是,能否超出既定规则内的变化,提出新的物理前提。作者也将这条世界模型路线主要放在物理研究中;数学与计算机科学的探索对象,可以是抽象结构和形式系统,不必照搬物理身体的经验。
自由落体为什么只能在局部“消去重力”?
这次比较两间都会让人失重的舱室:一间在深空漂浮,一间在地球引力中自由下落。观察者和小球最初相对静止,图形显示一小段时间后的相对位置。
概念示意:位移经过夸张,不对应实际尺寸或实验测量;比较时观察时长保持相同。
很小的局部:两种情景都近似保持相对位置
深空漂浮舱
忽略其他引力与小球间相互作用。舱体没有发动机加速,两球相对舱体漂浮。
地球附近自由落体舱
舱体和小球一起下落。虚线圆是初始位置;相隔较远的两球朝同一地心落去,会彼此靠近。
从这个假说到广义相对论,还缺什么?
- 把局部等效写成物理要求,并提出可检验后果。
- 寻找描述时空弯曲的数学工具,同时满足守恒和牛顿极限等要求。
- 回查错误约束、修正候选方程,不能把直觉当成完整理论。
- 用水星轨道等观测检查结果,再接受新的观测检验。
直觉不是理论:等效原理的严格物理边界
电梯思想实验提出了一个有用的原则,尚不足以单独确定完整的引力理论。这个原则本身也有明确的尺度条件。
1. 为什么要限定局部,并忽略潮汐效应?
地球附近的真实引力场并不完全均匀。设想同一自由落体舱内有两颗左右分开的球,它们最初相对舱体静止。两颗球都朝同一地心落去,所以除了共同下落外,还会缓慢彼此靠近。舱内观察者消去了共同下落,仍可能测到这点相对运动。
这就是潮汐效应的一种表现:不同位置受到的引力影响有差别。与之对照,在理想的深空惯性舱中,忽略其他引力及两球相互作用,初始相对静止的两球会保持间距。
观察范围越小、时间越短,这种差别越容易忽略。AEI 的等效原理讲解说明,“无限小时空区域”是数学极限表述;实际实验只需在相应精度下,把区域和时长取得足够小。扩大范围或延长观察,就可能测到潮汐效应,不能把局部近似直接推广到任意大的区域。
2. 从直觉公理到场方程的漫长跋涉
为什么这里开始谈几何?回看那两颗球:跟着舱体下落,可以消去共同下落,却不能同时消去整片区域里不同自由落体之间的相对变化。广义相对论用时空几何组织这些运动关系:没有受到推力等非引力作用的物体,沿时空中自然延伸的路径运动,这种路径称为“测地线”;邻近路径仍可能彼此靠近或远离。潮汐效应正是时空弯曲在相对运动中的表现。这给几何描述提供了直观动机,却还不能从一间电梯唯一确定完整理论。
要得到完整场方程,还需要寻找描述时空弯曲的数学工具,并让候选理论同时满足物理要求。爱因斯坦为此与数学家马塞尔·格罗斯曼合作。
这些要求会限制候选答案。例如,描述物质与能量怎样影响时空的方程,应与能量、动量守恒相容;在弱引力和慢速条件下,也必须恢复牛顿理论已经解释得很好的运动结果。电梯里的直觉并不直接给出这些要求的全部数学实现。
附录还列出一项更具体的要求:引力场自身携带的能量也参与引力作用,场会影响自身。这样一来,不能总把几个来源各自产生的引力效果直接相加,就当作合起来的最终答案;方程还要容纳这种反馈,这就是它需要非线性结构的一层物理原因。把这个要求写进数学,又是从直觉走向可计算理论的一步。
论文用《苏黎世笔记本》中的探索说明:他们一度接近适当的曲率工具,却因判断静态引力场及牛顿极限时采用了错误假设而放弃候选,随后在草案路线中反复修正。这里的问题是约束与前提的误判。
在逐步确定最终方程的过程中,水星轨道检验提供了重要支持;它并非等最终版本公布后才出现。最后建立的关系,可以概括为物质与能量的分布约束时空怎样弯曲,时空几何又决定自由落体怎样运动。从物理直觉到这样的可计算理论,中间还有数学构造、排错和观测检验。
反向论点与真实分歧:通往相对论是否只有一条路?
Yong Zheng-Xin 在回应文章《Hot Take: LLM can ‘jump’》中提出了一个反问:即使模型无法复制爱因斯坦的心理过程,是否仍能走另一条路线发现同样的理论?
他引用的费曼式路线,先借用狭义相对论,以及后来发展的量子场论对相互作用的描述,再结合引力的实验性质,限制候选引力模型。其技术起点称为“无质量自旋 2 场”。普通读者可以先抓住它的工作方式:选定一种候选场,要求它既符合已有理论的规则,又能一致地描述引力怎样作用于物质;这些条件必须同时成立,互相冲突的候选就要排除;施加这样的相互作用一致性要求,可以恢复广义相对论的结构。这条路线把别处已经建立的知识变成筛选条件,更依靠理论之间的联系与数学推导,不要求重演电梯思想实验。
这条反驳改变了可用知识条件。 量子场论是在广义相对论之后发展起来的;费曼也已经知道相对论的结果。事后重建已知理论,比在历史上首次提出它容易。Yong 自己承认,这条路线不能证明费曼必然会从零发现广义相对论,更不能证明只掌握爱因斯坦当时知识的 AI 已经能做到。
它的价值在于提醒我们:一种人类发现路径,未必是所有智能系统的必经之路。Yong 认为,当知识足够丰富时,系统可能从不同领域的矛盾或联系中提出新解释,再用代码、形式化证明或实验检验。跨领域知识连接能走多远,仍需要逐项验证。
两方关注的问题因此有所不同:Zahavy 追问物理新前提怎样从经验中产生;Yong 追问,更丰富的知识网络是否能提供另一条发现路径。解释了人类当年怎样发现,并没有排除未来机器怎样发现。
这篇论文究竟论证到了哪一步?
《LLMs can’t jump》的价值,是把“科学发现”拆开来看:从数据找规律、依前提推结果、提出新的解释性前提,以及让预测接受现实检验,分别需要什么能力。AlphaProof 的数学证明成绩和 AlphaEvolve 的算法结果,可以证明各自任务上的进展,不能自动回答新的物理前提来自哪里。
AlphaEvolve的过程尤其具体:语言模型提出程序,自动评估器运行并打分,演化过程再选择有前景的方案继续改进。它依赖可检查的反馈,但整套机制不能笼统说成只靠梯度下降;能够验证的新算法,也不能简单贬为复制旧知识。
Zahavy 对新前提来源的质疑,仍未构成现有模型做不到的证明。这篇立场论文没有设置历史知识截止的训练对照、不同模型的重发现成功率,也没有给出不可能性定理。官网后来进一步澄清:他认可基于 LLM 的真实科学发现,也承认继续扩展现有系统可能已经足够。
要判断机器是否跨出了那一步,至少需要分清它看过什么、提出了什么新假说、假说怎样接受独立检验。能流畅解释已知相对论,不能代替这样的证据;以爱因斯坦的发现过程为例,也不足以排除机器找到另一条有效道路。数据不足时如何产生值得检验的新前提,是这篇论文留下的具体研究问题。
LLMs can’t jump:数据稀缺时,AI 如何迈出物理“前提跳跃”?
Google DeepMind 研究员 Tom Zahavy 在立场论文《LLMs can’t jump》中追问:如果只给 AI 爱因斯坦当年掌握的知识与数据,它能否独立提出广义相对论所需的全新物理原理?这个问题比“AI 能不能做科学发现”更为精确。AlphaProof 能够在形式化规则下证明数学定理,AlphaEvolve 能够借助评估器进化优秀算法,但当数据极度匮乏、既有理论运行良好时,新公理究竟从何而来?
形式工具可检验推导,但前提真实性依赖物理观测
比较不同物体的下落记录,总结加速度一致性,推广仍需验证
构造心智实验,为后续推导与判决实验确立全新起点
计算机科学家施密德胡伯等人常将科学发现理解为“数据压缩”:用更紧凑的代码或规则解释更多观测。然而 Zahavy 指出,广义相对论诞生时并没有大批急迫的反常数据强行指引方向。牛顿引力能解释绝大多数天体运行,水星轨道近日点的异常,当时有人尝试用太阳附近的未见行星“祝融星”解释。
更重要的是,最终理论更简洁,也不等于寻找它的每一步都更简单。在探索途中,引入全新数学工具与反复修正的错误方程,反而会先急剧扩大搜索空间并提高复杂度。当时仍有水星异常,以及远距作用与相对论、场论之间的概念张力;数据少不等于没有反馈。如果系统的奖励函数只看眼前的数据拟合度或压缩率,是否足以促使系统放弃表现很好的旧框架、尝试新概念,仍是作者提出的疑问。
核心机制:爱因斯坦探索循环与“操纵式溯因”
爱因斯坦在致莫里斯·索洛文的信中,将科学创造描绘为闭环:经验 → 提出理论前提 → 推导可测后果 → 实验检验 → 新经验。这篇论文的核心关切,正是从经验迈向新理论前提的那一步“概念跳跃”。
爱因斯坦没有停留于解释“人为何失重”,而是将这种局部对应推广为物理原则:在足够小的自由落体实验室内,忽略潮汐效应,局部的非引力物理实验应当遵循与无引力惯性系相同的规律。Zahavy 将这种借助可操纵的心理场景产生解释的过程称为“操纵式溯因”:改变情境,比较后果,再提出更一般的假说。
因此,论文建议探索可主动干预、物理规律一致的世界模型,再把情景关系抽象成可检验命题。这是一条研究路线;能生成或操作环境,并未证明已具备发明新理论的能力。
直觉不是理论:等效原理的严格物理边界
电梯思想实验提出了一个有用的原则,尚不足以单独确定完整的引力理论。真实引力场并非完全平行均匀,这个原则本身受制于严格的尺度条件:
这就是潮汐效应的一种表现:不同位置受到的引力影响有差别。自由下落可以消去整体加速度,却无法消去时空弯曲产生的相对潮汐变化。广义相对论正是用时空几何(测地线偏离)来严格描述这种相对运动。
从思想实验到场方程的漫长跋涉:爱因斯坦与数学家格罗斯曼在《苏黎世笔记本》中历经数年曲折。候选方程不仅要与能量-动量守恒相容、在弱场慢速下回到牛顿极限,更由于引力场自身能量也参与引力相互作用,方程必须具备非线性结构。直觉只提供了方向,严密的数学工具与约束才是将公理变成可计算理论的桥梁。
通往相对论是否只有一条路?
针对 Zahavy 的论点,学者 Yong Zheng-Xin 在《Hot Take: LLM can ‘jump’》中提出了关键反问:即使模型无法重演爱因斯坦的人类心理体验,是否可以通过另一条路径抵达相同物理真理?
费曼路线的技术起点被称为“无质量自旋 2 场”。该方法使用更晚的量子场论,费曼也已经知道答案;重建不等于首次发现,更不是同样历史知识条件下的AI实验。它仍提示一种可能性:当智能系统拥有极其广博的多学科知识网络时,或许能够通过不同理论之间的数学冲突与自洽性约束,完成无需身体模拟的理论构建。
核心总结:这篇论文究竟论证到了哪一步?
《LLMs can’t jump》并非否定 AI 在科学研究中的已有进展。AlphaProof 在形式化定理证明上的成功、AlphaEvolve 在搜索与进化新算法上的突破,都证明了机器在规则明确、反馈即时领域的实际进展。这篇个人立场论文把问题细分为:在数据不足的物理探索中,新物理前提怎样产生、怎样独立检验?能流利解释已知相对论,不代表具备从零提出新公理的能力;而证明当年人类走过一条路,也未曾封死机器走出全新发现通道的可能。论文没有历史知识受控实验或不可能性定理;作者承认继续扩展现有系统可能已足够。
LLMs can't jump — Tom Zahavy
A position paper examining a fundamental limitation of large language models: their difficulty with abductive reasoning, a capacity central to genuine scientific invention.
I explore the fundamental nature of scientific invention, highlighting the critical gap between the ability of humans to create computational systems from physical intuition and current artificial intelligence capabilities. While modern Generative AI excels at pattern recognition (induction) and logical proofs (deduction), we argue it fundamentally lacks the capacity for "abduction"—the intuitive leap required to generate novel explanatory hypotheses.
Using Einstein’s formulation of General Relativity as a case study, we demonstrate that LLMs are structurally incapable of creating new foundational axioms, particularly when observational data is scarce. Ultimately, we propose that integrating physically consistent, multimodal world models is the key to bridging this divide and unlocking true artificial scientific invention.
Position paper, January 2026. Presented at ICML 2026.
Reception
The paper was posted to PhilSci-Archive in January 2026, where it is among the ten most-downloaded papers. It was widely discussed on X, LinkedIn and Reddit, reached the top of Hacker News, and was covered in the science press, by essayists, and in a number of newsletters and explainers. Selected coverage:
- Philip Ball, “The Einstein test: what happens when AI tries to rediscover relativity?”. Nature news feature, 9 September 2026.On 'vintage' language models trained on pre-1911 data and whether they could rediscover general relativity. Presents the paper as the detailed case for the test, and its argument that such a breakthrough requires abduction rather than induction.
- Ian Leslie, “Einstein, Churchill, and AI”. The Ruffian essay, 15 August 2026.An extended discussion of the paper's central example — Einstein's 1907 thought experiment — and its claim that the insight was grounded in physical experience rather than in words or symbols.
- Noah Smith, “The End of the Age of Heroes”. Noahpinion essay, 4 August 2026.On AI systems solving open problems in mathematics; cites the paper for the possibility that novel conceptual leaps remain a general limitation of current models.
Responses
- Yong Zheng-Xin, “Hot Take: LLM can ‘jump’”, 8 August 2026.Argues that general relativity could also have been reached by a more deductive route, and that models able to spot gaps between fields may not need the abductive step.
- HackerNoon, “LLMs Can’t Jump and They Shouldn’t Have To”, August 2026.Accepts the premise and draws a division of labour from it: AI for synthesis and verification, people for the leap.
A note on scope
Some of the discussion framed the paper as an argument that LLMs cannot make scientific discoveries, or as an institutional view. It is neither. It is a personal position paper, and as a contributor to AlphaProof I have seen first-hand that LLM-based systems are already making real discoveries, and will continue to.
The paper is narrower than that: it asks what it would take for a system to make one specific kind of jump — Einstein’s formulation of the equivalence principle from thought experiments grounded in physical intuition — and argues that current recipes do not obviously supply it. Whether that capability is the most urgent thing to build next is a separate question; it may well be that scaling current systems is enough. I wrote up these clarifications in a short note after the paper began circulating.